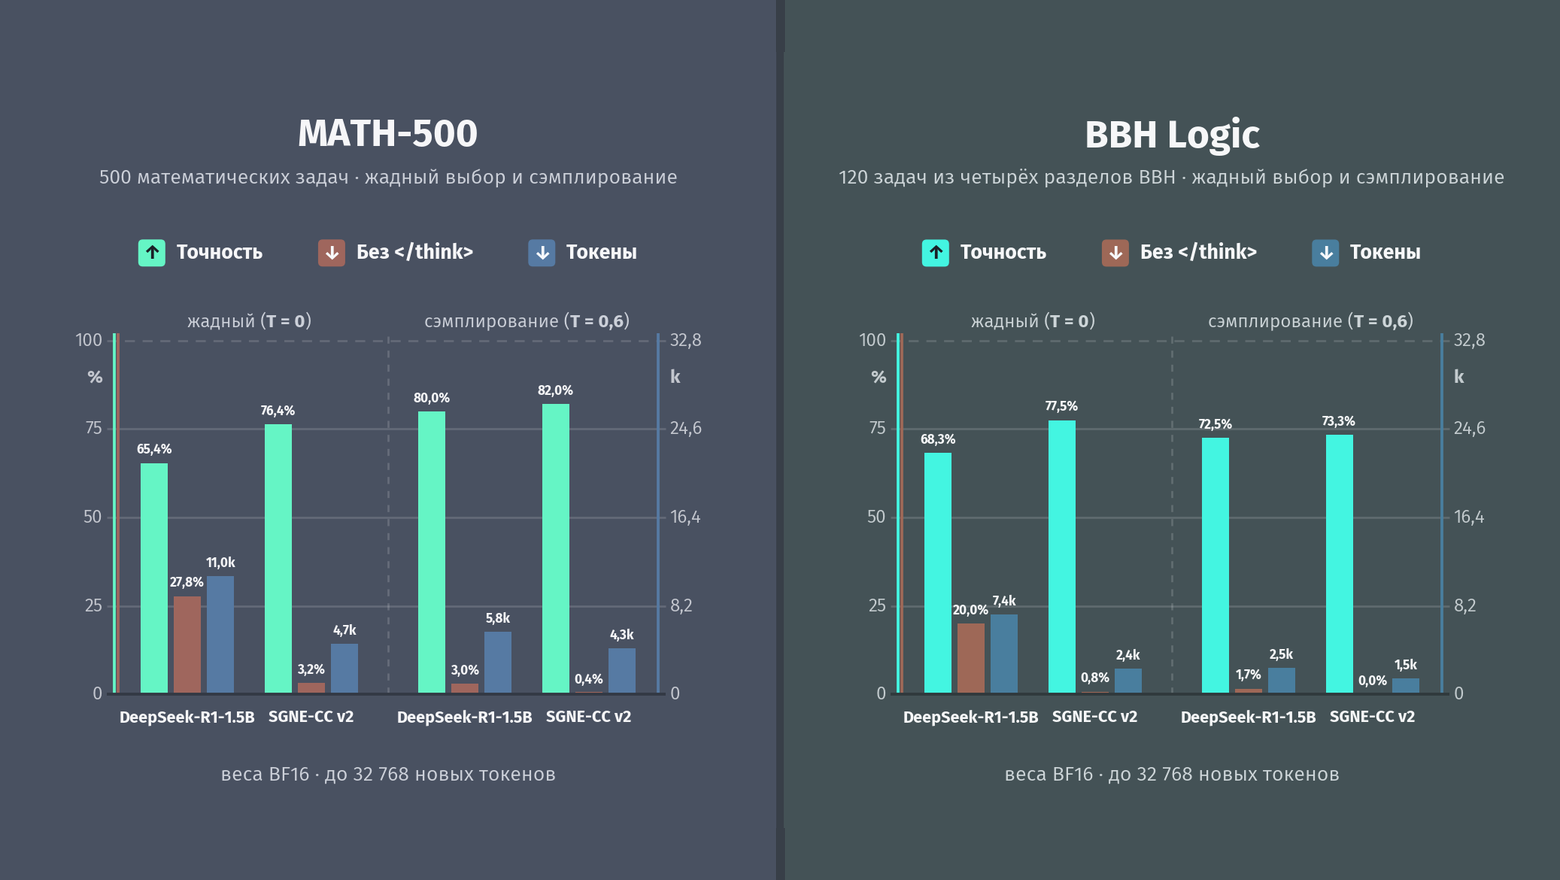
Правка SGNE-CC v2 для DeepSeek-R1-1.5B (T=0): −87% зависаний, ответы в 2.7 раза короче и +11 п.п. на MATH-500
При жадном выборе токенов (T = 0, без сэмплирования и штрафа повторов) рассуждающая модель DeepSeek-R1-Distill-Qwen-1.5B часто вязнет в бесконечной перепроверке уже найденного решения внутри <think> и упирается в потолок 32 768 токенов. Я перенёс открытую нормосохраняющую правку весов SGNE-CC с гибридной Qwen3.5-0.8B на этот чистый трансформер — без дообучения и без правок кода инференса. Чтобы остановить зацикливание в самих весах, оказалось достаточно повернуть всего 205 столбцов mlp.down_proj (0.0177% параметров, патч 603 КБ), не трогая слои внимания, ворота и нормировки: Прирост в жадном режиме (T = 0): на математике MATH-500 точность выросла с 65% до 76% (+11 п.п.), на задачах программирования MBPP — с 53% до 68%, на логике BBH — с 68% до 78%.Меньше обрывов и токенов (по всем 5 наборам, 1 054 задачи): доля незавершённых рассуждений упала на 87%, а средняя длина ответа сократилась в 2.7 раза (10.8k → 4.0k токенов).При стандартном сэмплировании (T = 0.6): точность не теряется (73% против 72%), остаточные зависания также снижаются на 86%, а генерация становится на треть короче. Под катом — локализация петли самокопирования в головах внимания, геометрия правки, честные границы метода (HumanEval, T = 0.3) и ссылки на патч и трассы 32K. Читать далее