📰 Все новости за последние 60 дней

DSL в эпоху ИИ: делать или не делать…
Всем привет. Меня зовут Сергей и я руковожу разработкой автоматизации внутренних бизнес-процессов в рамках Центра управления процессами Московской Биржи. В эпоху повсеместного распространения инструментов на базе искусственного интеллекта (ИИ) вопрос применения доменно-специфичных языков (DSL, domain specific language) вызывает неоднозначную реакцию. С одной стороны, большие языковые модели прекрасно понимают широкое многообразие естественного языка и могут работать напрямую с ним. С другой стороны, присущая любому человеческому общению неоднозначность оставляет простор для неправильных трактовок и ошибок. Интересно. Давай дальше...
🕒 02.10.2026 12:22
Читать полностью
Prediction-Powered Smoothing как главный метод оценки качества современных нейросетей
С развитием нейросетей неизбежно пришли две вещи: их интеграция во всё, куда можно (например, в телефон, робот-пылесос и холодильник), и связанный с этим вопрос контроля качества. Рано или поздно возникнет логичный вопрос: а как вообще оценивать работу ИИ за пределами очень обобщенного вопроса «вот тут ответ нейронки неверный, а вот там она долго думает над ответом»? Нейросети, как показала практика, например, социальной сети Илона Маска, нельзя пускать к людям без тщательной проверки, иначе всё это превратится для пользователей в балаган из смешных ответов, а для продакшн-команды в катастрофу. И что очевидно, способов это не допустить достаточно, только вот всё с нюансами. И в этом материале предлагаю посмотреть на совершенно новый метод оценки ИИ, который представили эксперты Сё Кавано, Цзэхан Ричард Ли и Пол А. Паркер в научной работе под названием «Prediction-Powered Smoothing and Validation for Disaggregated AI Evaluation».. Разберем, как устроен этот подход под капотом, как он «заимствует силу» у смежных задач и почему именно он становится главным фундаментом для безопасных и экономически оправданных релизов современных нейросетей. Читать далее
🕒 02.10.2026 12:17
Читать полностью
Как пользоваться LMArena (arena.ai): как читать рейтинг и выбрать лучшую модель под свою задачу
LMArena помогает сравнивать нейросети по результатам реальных пользовательских голосований — в рейтинге можно посмотреть, какие модели лучше справляются с текстом, кодом, изображениями, поиском и другими задачами. Проблема в том, что общий Rank сам по себе мало что говорит: модель из топа Overall вполне может уступать конкурентам именно в вашем сценарии. Чтобы нормально пользоваться LMArena, нужно разобраться в интерфейсе, категориях рейтинга и дополнительных показателях, иначе легко выбрать модель по красивой цифре в общей таблице и получить посредственный результат. В этой статье разберём LMArena по шагам: что показывает каждый раздел, как читать рейтинг и позиции моделей, зачем переключать категории и как в итоге выбрать нейросеть под конкретную задачу. Читать далее
🕒 02.10.2026 11:24
Читать полностью
Прорыв GPT-6 Astra, Claude взрослеет до версии 5.5, скандал вокруг задачи Навье-Стокса: главные события в ИИ за сентябрь
Как и ожидалось, после августовского затишья ИИ-лаборатории устроили нам целый хит-парад релизов. Глаза разбегаются от обилия версий, цифр и апдейтов, которыми компании пытаются перебить инфоповоды друг друга. От OpenAI мы получили разрывающую бенчмарки GPT-6 Astra, Sol аж в двух версиях и целую пачку обновлений с прошедшего DevDay. Anthropic выставили в ответ тяжелую артиллерию в лице Claude Fable 5.1 и семейства Claude 5.5 в неполном составе. Google же продолжают штамповать Flash-версии Gemini и, видимо, копят ульту под какой-то мощный будущий релиз. За пределами релизов развернулись сюжеты не менее интересные. OpenAI торжественно объявили о решении задачи Навье-Стокса силами своих агентов, но вместо оваций получили обвинения в краже данных и гнев научного сообщества. Лидер Anthropic тоже получил свою долю хейта, только уже от политиков, за призывы замедлить ИИ-гонку. Дженсен Хуанг тем временем продолжает укреплять свою монополию, на этот раз через покупку Hugging Face.В конце выпуска вас ждет наша традиционная сводка полезных инструментов и выжимка свежих научных исследований. Присоединяйтесь, впереди много интересного! Читать далее
🕒 02.10.2026 11:08
Читать полностью
FAIRouter. Мы научили ИИ выбирать лучшую LLM модель для каждой задачи
Привет! Мы выложили в открытый доступ библиотеку FAIRouter, которая выбирает LLM-исполнителя под задачу, а после ответа принимает у него работу. В мире, где количество больших языковых моделей (LLM) растет в геометрической прогрессии, а их возможности и стоимость сильно варьируются, встает вопрос: как выбрать именно ту модель, которая идеально подойдет для конкретной задачи, обеспечит наилучшее качество и при этом будет экономически эффективной? Для решение вышеописанной проблемы мы разработали обучаемую систему автоматической маршрутизации запросов FAIRouter. Читать далее
🕒 02.10.2026 10:50
Читать полностью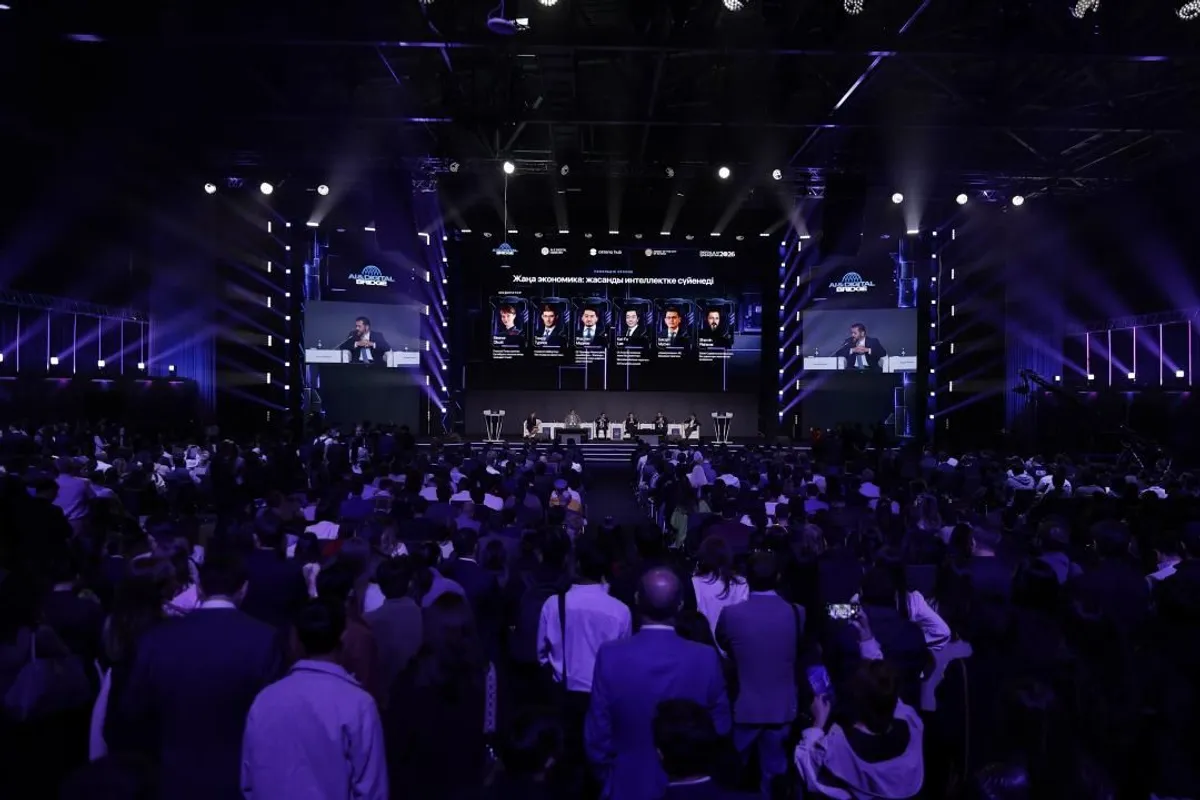
Казахстан начнет экспорт компьютерных токенов в 2027 году
На Digital Bridge представили проекты развития AI-экономики страны
🕒 02.10.2026 09:11
Читать полностью
OpenAI связала часть кампании по извлечению рассуждений с Moonshot AI
OpenAI раскрыла результаты расследования июльской кампании по извлечению защищенных рассуждений ее ИИ-моделей. Эксперты связали ядро активности с людьми, ассоциированными с китайским разработчиком Moonshot AI, но не утверждает, что все выявленные операторы относились к одному субъекту.
🕒 02.10.2026 08:21
Читать полностью
Как выбрать и проверить LLM для рабочих задач: Claude, GPT, Gemini и другие модели
Новая LLM обошла конкурентов в работе с кодом. Но справится ли она с ошибкой в вашем репозитории? А модель, которая хорошо анализирует документы, — с таблицами, где возвраты лежат в отдельном файле, а правила расчёта выручки менялись три раза?Опубликованные тесты помогают выбрать несколько моделей для сравнения. Дальше нужны собственная задача и понятные условия приёмки: что должно получиться, как проверить результат и сколько ручной работы допустимо. Привет! Я Игорь Зуриев, руководитель проектов по автоматизации бизнеса и внедрению систем на базе ИИ. Больше десяти лет управляю ИТ-проектами, в том числе для заказчиков из нефтегазовой отрасли и строительства — «Лукойла», аэропорта Шереметьево, «Трансгаза». Автор и преподаватель программ по ИТ-проектам и цифровым продуктам, в том числе в Университете Иннополис. В школе Karpov.Courses преподаю применение ИИ для анализа данных. Веду в ТГ канал «Нейросетка». Сам использую ИИ для работы с кодом, документами и прототипами. Fable 5.1 понравилась мне тем, что код получался практически без ошибок с первого раза. В Stitch я описывал изменения интерфейса словами и сравнивал варианты экранов. А один из запусков Sonnet 5 закончился исчерпанием лимита без готового результата. Поэтому меня интересует и качество ответа, и то, сколько работы после него остаётся человеку. Читать далее
🕒 02.10.2026 08:03
Читать полностью
Разбор Jev — модели, которая не умеет писать
Утро началось с того, что ко мне в личку пришел друг и спросил: «Кто это такой, этот Jev? Ты работаешь с ИИ, должен знать». К этому моменту я уже видел десятки постов в ленте о том, насколько он крут, какие задачи решает, и призывы переносить все свои флоу на Jev. Давайте разбираться. Читать далее
🕒 02.10.2026 08:00
Читать полностью
50 лет эволюции поиска по коду: что под капотом кодинговых агентов
Когда мы просим Claude Code, Codex или Cursor «починить вот эту функцию», то сначала надо понять, где этот код вообще находится. В каком файле? В какой функции? Как она называется и кто её вызывает? Через какие еще системы пролетают байтики наших данных? За последние полвека для этой задачи придумали огромное количество инструментов: grep, текстовые индексы, полнотекстовый поиск, ctags, LSP, AST, анализ потоков данных, графы, поиск по смыслу и многое другое. Самое забавное, что весь зоопарк с нами и почти ничего из этого не умерло. В 2026 году поиск по коду в лучших кодинговых агентах по-прежнему состоит из алгоритмов и технологий, которым пять, десять, тридцать, а иногда и больше пятидесяти лет (grep вышел в 1973 году!). И в этой огромной статье я расскажу об эволюции этих технологий, истории и философии их создания, решаемых проблемах и способе работы. Погнали! Читать далее
🕒 02.10.2026 07:52
Читать полностью